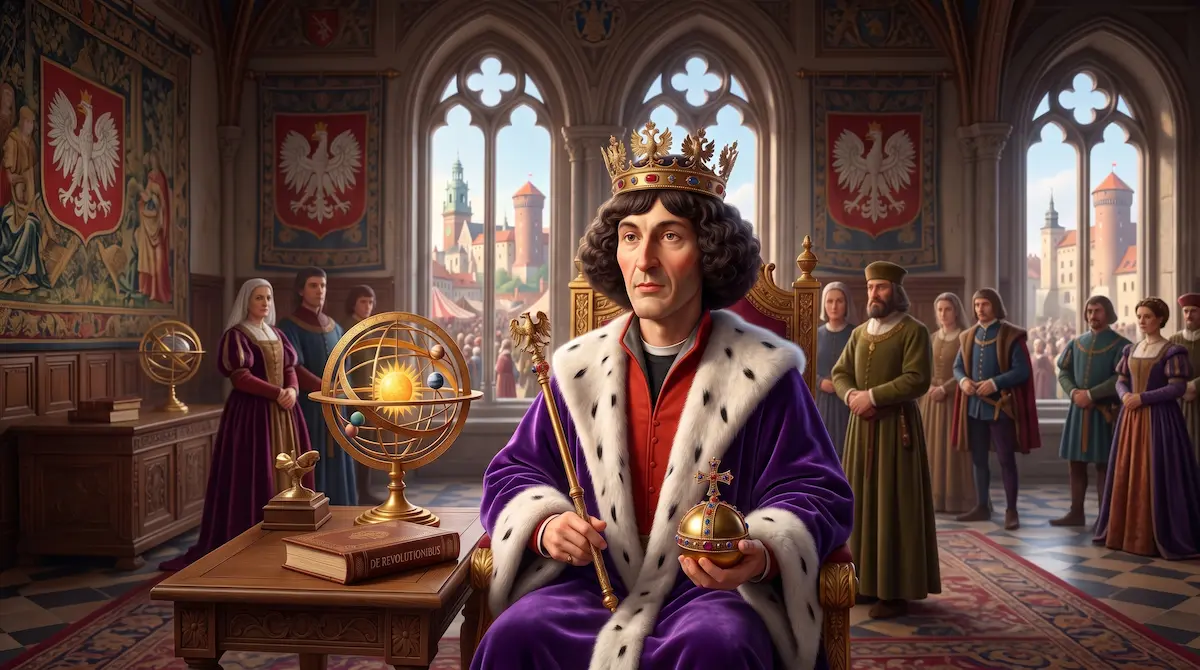

Zapytane o rządy królów z dynastii Jagiellonów, AI potrafiło dopisać do listy Mikołaja Kopernika, argumentując, że „skoro był tak ważny i znany, to musiał rządzić krajem”. Pomyłki sztucznej inteligencji potrafią zaskoczyć, zwłaszcza że modele językowe często przedstawiają błędne informacje z absolutną pewnością siebie. Zrozumienie, gdzie i dlaczego algorytmy się mylą, to dzisiaj podstawa pracy z AI. Dlatego zapraszam na nieco dłuższą lekcję, jak rozpoznawać i weryfikować błędy sztucznej inteligencji.
Oto katalog najczęstszych potknięć sztucznej inteligencji, z którymi będziemy spotykać się na co dzień:
1. Halucynacje (niektórzy precyzują: konfabulacje), czyli zmyślanie faktów
O halucynacjach czatbotów słyszał już chyba każdy – to w końcu ich najsłynniejsza słabość. Warto pamiętać, że model językowy nie jest encyklopedią ani klasyczną bazą danych, z której po prostu „kopiuje” gotową odpowiedź. On ją za każdym razem tworzy od zera. W dużym uproszczeniu AI to taki wielki, zaawansowany kalkulator, który na podstawie wcześniejszych treningów oblicza statystyczne prawdopodobieństwo wystąpienia kolejnego słowa (a dokładnie fragmentu tekstu, czyli tzw. tokenu).
Jeśli zapytamy algorytm o rzadkie zjawisko, mało znaną osobę albo nieistniejącą publikację, może wygenerować wiarygodnie brzmiącą, lecz całkowicie zmyśloną biografię, datę lub bibliografię. Jednak te najbardziej zdradliwe halucynacje to dziś zazwyczaj „drobne” pomyłki. Czatbot potrafi z pełnym przekonaniem podać nieaktualny cennik, opisać interfejs aplikacji, który zmienił się miesiąc temu, albo sprytnie wymieszać życiorysy dwóch różnych osób o podobnym nazwisku.
Skala tego zjawiska zależy od wielu czynników (między innymi od samego modelu i sposobu sformułowania naszego pytania). Najważniejsza lekcja? Każda odpowiedź sztucznej inteligencji to tylko propozycja, a nie bezwzględny fakt.
2. Błędy logiczne i matematyczne
Modele językowe potrafią rozwiązywać zadania matematyczne, ale ich skuteczność bywa mocno nierówna. Znacznie częściej potykają się na zagadkach przestrzennych i problemach logicznych, które wymagają konsekwentnego prowadzenia rozumowania krok po kroku. Notorycznie zdarza im się także ignorować wytyczne dotyczące konkretnej liczby słów lub znaków w generowanym tekście.
Do tego dochodzi kwestia naszej komunikacji – zagmatwane i przeładowane prompty to absolutna klasyka. Jeśli przy skomplikowanym, wieloetapowym zadaniu wrzucisz do jednego polecenia pięć różnych próśb, czatbot zachowa się dokładnie jak przebodźcowany uczeń: dwa punkty zrobi świetnie, a resztę zignoruje lub kompletnie pomiesza. Dlatego w takich sytuacjach zasada jest prosta: prowadzimy AI za rękę i podajemy polecenia krok po kroku, jedno po drugim.
3. Bias, czyli uprzedzenia i stereotypy
Modele uczą się na gigantycznych zbiorach tekstów tworzonych przez ludzi, dlatego siłą rzeczy mogą odtwarzać obecne w tych materiałach uprzedzenia społeczne, kulturowe i językowe. W domyślnym świecie AI pielęgniarka to często kobieta, prezes to mężczyzna, a kultura zachodnia bywa przedstawiana jako uniwersalny punkt odniesienia dla całego świata.
Nie oznacza to oczywiście, że każdy algorytm zawsze wpadnie w tę pułapkę (pamiętajmy, że modele stale się uczą i są korygowane przez twórców!), ale warto mieć to z tyłu głowy. Odpowiedzi sztucznej inteligencji powinniśmy po prostu analizować pod kątem jednostronności i powielania stereotypów.
4. Sykofancja, czyli efekt potakiwania
Modele są często dostrajane tak, aby były dla nas maksymalnie pomocne i odpowiadały zgodnie z naszą intencją. Czasami prowadzi to jednak do tzw. nadmiernego potakiwania.
Jeśli uczeń zawrze w pytaniu stronniczą lub wręcz błędną tezę – na przykład pytając: „Dlaczego koty są lepszymi pupilami od psów?” – model może gładko przyjąć to założenie i wygenerować pozornie logiczne, wspierające je wyjaśnienie. Gdy natomiast otworzymy nowe okno czatu i zapytamy odwrotnie: „Dlaczego to psy są lepszymi pupilami od kotów?”, dostaniemy równie mocne i przekonujące uzasadnienie naszej nowej tezy. Dlatego warto sprawdzać, czy sztuczna inteligencja po prostu bezkrytycznie nie „odbiła” i nie przytaknęła założeniom przemyconym w naszym własnym pytaniu.
5. Gubienie wątku i ograniczenia kontekstu
W długich rozmowach model może w pewnym momencie przestać poprawnie wykorzystywać nasze początkowe instrukcje. Zdarza mu się pomylić role, pominąć wcześniejsze ustalenia, naruszyć zasady formatowania albo po prostu wrócić do swoich „fabrycznych” ustawień i domyślnego sposobu odpowiadania.
Nie zawsze jest to jednak dosłowne „zapominanie”. Przyczyną bywa po prostu wyczerpanie pamięci czatu (tzw. okna kontekstowego), zbyt długa lista wytycznych lub niejednoznaczne polecenia. Warto tu pamiętać o jednej kluczowej zasadzie: prawdziwą naturą czatbotów jest generowanie treści za każdym razem od nowa, a nie precyzyjne nanoszenie korekty. Kiedy więc po raz dziesiąty prosimy model o poprawienie jednego słowa w tekście, AI – zamiast dokonać chirurgicznego cięcia – często woli przepisać cały materiał od zera, gubiąc przy okazji połowę naszych pierwotnych założeń. Dlatego sprytnym rozwiązaniem jest pracować etapowo na mniejszych fragmentach tekstu. Budować cegiełka po cegiełce, a nie od razu cały wieżowiec.
Kiedy AI myli się najczęściej?
Sztuczna inteligencja jest szczególnie podatna na błędy, gdy pytamy ją o:
- bardzo niszowe lub słabo udokumentowane tematy;
- lokalne ciekawostki i informacje trudne do znalezienia w sieci;
- najświeższe wydarzenia (zwłaszcza, jeśli dany model nie ma aktywnego dostępu do internetu);
- osoby, publikacje i wydarzenia o podobnie brzmiących nazwach (tu algorytmy uwielbiają tworzyć zmyślone „hybrydy”);
- zadania sformułowane nieprecyzyjnie lub z góry zawierające fałszywe założenie;
- problemy wymagające długiego, bezbłędnego rozumowania,
- edycję wygenerowanych już multimediów (o ile obrazki można jeszcze próbować częściowo korygować – choć i tu prośba o zmianę samego koloru czapki czasem kończy się wygenerowaniem postaci od zera – o tyle w przypadku AI muzycznego drobne poprawki są obecnie niemożliwe. System nie zmieni jednego akordu czy fragmentu wokalu, lecz po prostu wygeneruje zupełnie nowy utwór od początku według nowych wytycznych),
- szybkie odpowiedzi w trybie głosowym (w konwersacji audio priorytetem algorytmu jest płynność i „vibe” rozmowy, co znacznie zwiększa ryzyko zmyślania. Jeśli zależy Ci na analitycznej precyzji, zawsze wybieraj pisanie na klawiaturze).
Dobra wiadomość jest taka, że nie musimy obsesyjnie sprawdzać każdego wygenerowanego słowa. Poziom weryfikacji powinien zależeć po prostu od tego, jakie będą konsekwencje ewentualnego błędu. Najlepiej podzielić to na dwie strefy.
Strefa niskiego ryzyka: twórczość i forma
Jeśli używasz AI do burzy mózgów, generowania pomysłów na szkolne zabawy, poprawiania literówek w mailu do nauczyciela albo pisania bajki, weryfikacja twardych faktów schodzi na dalszy plan. W takich zadaniach liczy się przede wszystkim kreatywność, styl i zgodność z poleceniem. Oczywiście nie oznacza to, że odpowiedzi nie trzeba czytać. Warto po prostu sprawdzić, czy tekst jest zrozumiały, język odpowiedni dla odbiorcy, a model właściwie uchwycił nasze intencje.
Strefa wysokiego ryzyka: fakty i nauka
Tutaj włączamy ograniczoną dozę zaufania. Jeśli uczeń przygotowuje referat z historii, szuka twardych informacji z biologii, albo Ty sprawdzasz kwestie prawne, medyczne lub finansowe – zapala się czerwona lampka. Najważniejsze fakty, nazwiska, daty i liczby należy bezwzględnie zweryfikować w wiarygodnym, tradycyjnym źródle poza samym czatbotem.
Jak weryfikować informacje? Zostań cyfrowym detektywem
Weryfikacja informacji wygenerowanych przez AI to dziś nierzadko praca czysto detektywistyczna. Najlepiej nie polegać na jednym, magicznym triku, ale wyrobić w sobie (i w uczniach) nawyk łączenia kilku poniższych metod.
- Szukaj źródła pierwotnego: Weryfikację zawsze zaczynamy od kliknięcia w podany przez czatbota link, ale tutaj musimy być sprytni. Warto odróżniać źródła pierwotne — na przykład oryginalną ustawę, pełny raport medyczny, wyniki badania lub oficjalne dane — od artykułów, streszczeń i internetowych wpisów, które tylko opisują cudze ustalenia. Dlaczego to takie ważne? Bo każde kolejne omówienie działa trochę jak zabawa w głuchy telefon. Dziennikarz czy bloger mógł coś uprościć lub źle zrozumieć, a sztuczna inteligencja bezkrytycznie powieli ten błąd jako żelazny fakt. Kiedy już dotrzesz do materiału, upewnij się: kto jest jego autorem, kiedy go opublikowano lub zaktualizowano, czy autor ma kompetencje w danej dziedzinie i czy cytowany przez AI fragment faktycznie potwierdza jej tezę, czy też został sprytnie wyrwany z kontekstu.
- Uwaga na efekt echa (porównywanie źródeł): Szukając potwierdzenia ważnego faktu, staraj się korzystać z niezależnych od siebie miejsc. Jeśli znajdziesz pięć stron, które słowo w słowo kopiują ten sam błąd ze zmyślonego artykułu, sama liczba wyników w wyszukiwarce nie zamieni kłamstwa w prawdę.
- Krojenie tekstu na kawałki: Długi, spójny wywód wygenerowany przez AI usypia czujność. Najlepiej podzielić go na mniejsze twierdzenia i przy każdym postawić znak zapytania. Czy to twardy fakt, czy tylko opinia lub interpretacja modelu? Czy źródło potwierdza całe to zdanie, czy może tylko jego pierwszą połowę, a reszta to radosna twórczość bota?
- Czerwona flaga – cytaty, liczby i bibliografie: W tym miejscu zasada ograniczonego zaufania musi działać na 200%. Dokładne cytaty, statystyki, procenty, daty, nazwiska, tytuły książek i artykułów, numery stron, identyfikatory publikacji oraz linki wygenerowane przez model to obszary, w których sztuczna inteligencja zmyśla z największą gracją. Potrafi przypisać prawdziwy cytat zupełnie innej osobie albo wygenerować linki, które prowadzą donikąd. Bibliografię sprawdzamy zawsze u źródła (w bibliotekach i bazach naukowych), a nie kopiujemy bezkrytycznie z okna czatu.
Sprytne prompty, które ułatwiają weryfikację
Możemy też zaprząc samo AI do pomocy w sprawdzaniu faktów, używając do tego odpowiednich komend:
Zmuś model do przyznania się do niewiedzy: Zamiast pytać po prostu „Czy ten tekst jest poprawny?”, użyj precyzyjnej instrukcji:
Przeanalizuj tekst zdanie po zdaniu. Dla każdego twierdzenia wskaż, czy jest potwierdzone, niepotwierdzone, czy sprzeczne ze źródłem. Jeśli nie masz wystarczających podstaw, napisz wprost: Nie da się tego ustalić na podstawie dostępnych materiałów. Nie uzupełniaj luk domysłami.To genialnie temperuje zapędy modelu do udzielania odpowiedzi za wszelką cenę.
Weryfikacja w przeciwną stronę (prowokowanie modelu): To fenomenalne ćwiczenie na krytyczne myślenie dla starszych uczniów. Zamiast pytać, czy dana teza jest prawdą, poproś czatbota:
Znajdź argumenty lub rzetelne źródła, które podważałyby tę tezę.To natychmiast pomaga wykryć jednostronne ujęcie tematu i pozwala wyjść z bańki informacyjnej.
Termin przydatności do spożycia (sprawdzanie aktualności)
Pamiętajmy o starych cennikach i interfejsach! Wiele informacji (przepisy prawa, dane statystyczne, zalecenia medyczne czy funkcje aplikacji) jest poprawnych tylko w konkretnym momencie. Zawsze zwracajmy uwagę na datę publikacji i to, do jakich zasobów czasowych nasz model ma aktualnie dostęp.
Dostęp do internetu trzeba czasem po prostu wymusić promptem. Nawet jeśli „wielka czwórka” (Gemini, ChatGPT, Copilot, Claude) w swoich głównych, komercyjnych interfejsach ma już dostęp do sieci na żywo, algorytmy są zaprogramowane tak, aby optymalizować zasoby.
Jeśli zapytasz czatbota: „Ile kosztuje subskrypcja aplikacji X?”, może on uznać, że ta informacja znajduje się w jego stałej bazie wiedzy i odpowiedzieć z pamięci. Sęk w tym, że jego pamięć może dotyczyć cennika sprzed pół roku – i w ten sposób, z pełną pewnością siebie, wygeneruje dla nas nieaktualną halucynację.
Kiedy jednak napiszesz to tak:
Sprawdź na oficjalnej stronie aplikacji aktualne na dziś ceny...…dajesz modelowi bezwzględną komendę. Zmuszasz go do pominięcia jego wewnętrznej „pamięci”, uruchomienia przeglądarki i ściągnięcia danych prosto z konkretnego adresu URL. W żargonie inżynierów AI nazywamy to „uziemieniem” (grounding) – mocno przywiązujemy model do konkretnego, zewnętrznego źródła w czasie rzeczywistym.
Krzyżowe sprawdzanie chatbotów (niech AI sprawdzi AI)
Możemy też wykorzystać same modele do wzajemnej kontroli. Wystarczy wkleić tekst wygenerowany przez jedno narzędzie (np. ChatGPT) do okna konkurencji (np. Gemini lub Claude) z konkretnym poleceniem:
Działaj jako surowy, krytyczny redaktor i sprawdzacz faktów (fact-checker). Wskaż wszystkie błędy logiczne, merytoryczne i możliwe halucynacje w poniższym tekście. Przy każdym zarzucie krótko wyjaśnij, jak mogę zweryfikować daną informację.To błyskawiczny sposób na wyłapanie największych bzdur. Trzeba jednak uważać na haczyk: to nie jest metoda w stu procentach niezawodna. Dwa różne modele mogą z łatwością powtórzyć ten sam popularny mit albo bezkrytycznie zaakceptować fałszywą informację. Dlatego traktujmy to krzyżowe odpytywanie wyłącznie jako pierwszy filtr, a nie ostateczną wyrocznię.
Perplexity – game-changer w edukacji i weryfikacji
To narzędzie to trochę inna bajka. Zamiast „mówić z pamięci” (i czasem zmyślać), Perplexity łączy generowanie tekstu z aktywnym przeszukiwaniem internetu. Co najważniejsze – do każdej swojej odpowiedzi od razu dodaje przypisy i linki do konkretnych stron, na których się oparło.
Dla ucznia i nauczyciela to fantastyczne rozwiązanie. Użytkownik nie dostaje po prostu gotowca, lecz konkretny punkt wyjścia do dalszej pracy. Jeśli chce sprawdzić konkretne zdanie, klika w numerek obok tekstu i ląduje bezpośrednio na stronie źródłowej, by porównać odpowiedź z oryginałem.
Ale uwaga, nie wyłączamy czujności! Sama obecność przypisu nie jest magiczną gwarancją prawdy. Podlinkowane źródło może być przestarzałe, nierzetelne, albo… wcale nie potwierdzać tego, co radosnym tonem wygenerował model. Perplexity to genialne narzędzie ułatwiające poszukiwania, ale w żadnym wypadku nie zastąpi naszego krytycznego myślenia.
Bezpieczna piaskownica, czyli praca na własnych źródłach
Najbezpieczniejszym rozwiązaniem nie zawsze jest wpuszczanie czatbota do bezkresnego (i pełnego błędów) oceanu internetu. Jeśli mamy rzetelny materiał — na przykład podręcznik, artykuł naukowy, raport, akt prawny lub dokument z urzędu — możemy wgrać go bezpośrednio do narzędzia (wiele z nich świetnie radzi sobie z plikami PDF) i narzucić twardą zasadę: pracuj wyłącznie na podstawie tego pliku.
Przydatne polecenia do pracy z PDF-ami:
- „Streść ten dokument w pięciu punktach”.
- „Odpowiadaj wyłącznie na podstawie załączonego pliku. Nie korzystaj z wiedzy zewnętrznej”,
- „Wskaż dokładną stronę i fragment tekstu, który potwierdza każdą Twoją odpowiedź”,
- „Które informacje z mojej notatki znajdują potwierdzenie w tym dokumencie?”,
- „Porównaj te dwa teksty i wskaż, gdzie się różnią”,
- „Czego NIE da się ustalić na podstawie tego materiału?”,
- „Oddziel twarde fakty przedstawione w źródle od własnych wniosków i interpretacji”.
Szczególnie cenne jest to przedostatnie polecenie. Nakazanie modelowi, by otwarcie przyznawał się do braków w dokumencie, drastycznie ucina jego zapędy do łatania luk domysłami.
Trzeba jednak pamiętać o jednym haczyku: AI potrafi źle odczytać nawet najbardziej rzetelny plik. Może zignorować kluczową tabelę, pomylić przypisy, polec na wielokolumnowym układzie gazety albo źle zinterpretować skomplikowany wykres. Wgranie własnego PDF-a drastycznie zmniejsza ryzyko halucynacji, ale na koniec i tak musimy rzucić okiem na wskazany przez bota fragment.
Dokumentowanie procesu (szkolny standard przyszłości)
W edukacji i pracy zawodowej warto wyrabiać nowy, bezcenny nawyk: tworzenie metryczki pokazującej, jak współpracowaliśmy z algorytmem. Przejrzyste opisanie tego procesu buduje zaufanie i udowadnia, że autor nie potraktował czatbota jako magicznej wyroczni.
Co warto zanotować:
- z jakich źródeł korzystano (i kiedy),
- jakiego narzędzia AI użyto (np. ChatGPT, Claude, Perplexity),
- do czego dokładnie zaprzęgnięto AI (np. korekta językowa, burza mózgów, streszczenie trudnego tekstu),
- które fragmenty i kluczowe fakty zostały samodzielnie zweryfikowane.
Prosty schemat weryfikacji (gotowy plakat do pracowni!)
Cały ten detektywistyczny proces można sprowadzić do pięciu jasnych kroków, które świetnie sprawdzą się jako zasady w szkolnej pracowni komputerowej:
- Wybierz wiarygodne źródło.
- Poproś AI o analizę, a nie o bezkrytyczne napisanie tekstu od zera.
- Sprawdź, na jakim dokładnie fragmencie oparto odpowiedź.
- Porównaj kluczowe informacje z niezależnym źródłem.
- Samodzielnie sformułuj i podpisz końcowy wniosek.
W skrócie: źródło → odpowiedź AI → kontrola fragmentu → porównanie → własny wniosek.
To Ty jesteś u steru
Wielu z nas chciałoby, aby sztuczna inteligencja była narzędziem absolutnie idealnym i nieomylnym. Kiedy potyka się na prostych faktach, łatwo o rozczarowanie i krytykę. Zapominamy jednak o fundamentalnej kwestii: praca z AI to wciąż Twoja praca. Jesteś po prostu człowiekiem wyposażonym w supernarzędzie. Nie ma tu mowy o magii, która zrobi wszystko za Ciebie.
Krytyczne korzystanie ze sztucznej inteligencji polega na tym, aby używać jej do rzucania wyzwań własnemu myśleniu lub do jego rozszerzania, a nie do zastępowania samodzielnego, logicznego rozumowania, ludzkiej kreatywności czy prostej obserwacji realnego świata.
W tej współpracy to Ty jesteś u steru. Algorytmy mogą dawać potężny napęd, ale to w Twoim interesie leży, by zatrzymać się na chwilę i zastanowić, czy na pewno wiosłujesz we właściwym kierunku. Ostatecznie – podobnie jak w życiu – to Ty ponosisz pełną odpowiedzialność za rezultat swojej pracy, a nie czatbot, z którym rozmawiasz. I to jest wspaniała wiadomość. Kiedy dobrze poznasz i zaakceptujesz zarówno niesamowite możliwości, jak i naturalne ograniczenia AI, przestajesz być biernym odbiorcą. Zyskujesz świadomość, dzięki której możesz odważnie przekraczać swoje dotychczasowe granice.